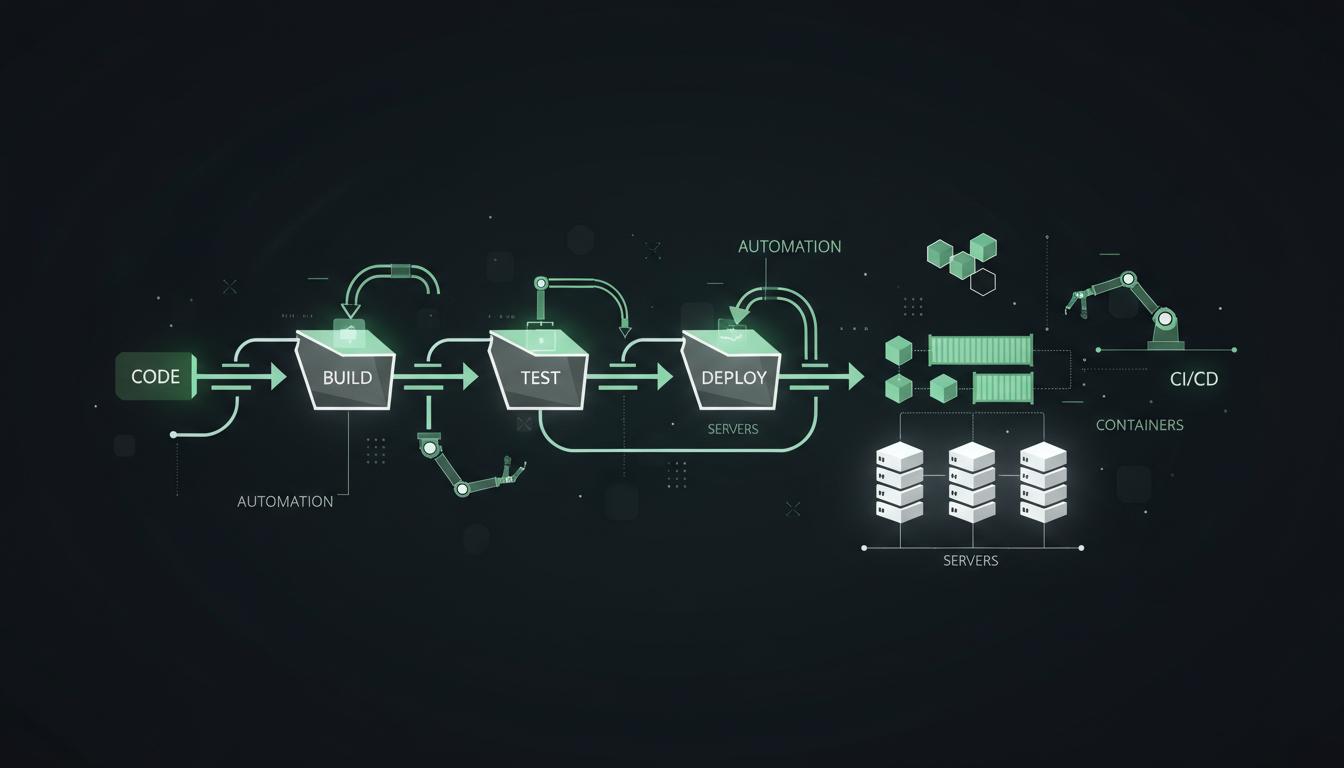
DevOps без хаоса: как правильно запускать цифровые продукты
Практический гайд по CI/CD, инфраструктуре и процессам для команд, которые хотят деплоить быстро и не ломать production.
Проблема: деплой = стресс
Во многих командах деплой в production — это событие. Созваниваются все, готовятся к откату, молятся, чтобы ничего не сломалось. Это не DevOps. Это выживание.
Настоящий DevOps — это когда деплой происходит десятки раз в день автоматически, без стресса и с уверенностью, что если что-то пойдёт не так — система сама откатит изменения.
CI/CD: автоматизируйте всё
Continuous Integration
- Каждый commit запускает тесты
- Code review обязателен — ни одна строка не попадает в main без аппрува
- Linting, type checking, security scanning — всё в пайплайне
- Сборка артефактов (Docker image) после успешных тестов
Continuous Deployment
- Успешный build автоматически деплоится в staging
- Smoke tests проходят на staging
- Production deploy — один клик или полностью автоматический
- Feature flags позволяют включать функционал без деплоя
Практический стек
- GitHub Actions / GitLab CI для пайплайнов
- Docker для контейнеризации
- Kubernetes для оркестрации
- ArgoCD для GitOps-деплоя
Среды: dev, staging, production
Development — локальная среда разработчика. Должна подниматься за одну команду (docker-compose up).
Staging — копия production с анонимизированными данными. Здесь тестируются интеграции, performance и acceptance criteria.
Production — живые пользователи. Сюда попадает только то, что прошло все проверки.
Правила
- Staging максимально похож на production (инфраструктура, версии, конфигурация)
- Никаких ручных правок в production
- Все изменения через Git → CI/CD → deploy
- Database migrations — отдельный controlled процесс с rollback-plan
Мониторинг: знайте раньше пользователей
Если вы узнаёте о проблеме от пользователя — вы опоздали. Хороший мониторинг даёт минуты или часы на реакцию до того, как проблема затронет бизнес.
Что мониторить
- **Application metrics:** response time, error rate, throughput
- **Infrastructure metrics:** CPU, memory, disk, network
- **Business metrics:** заказы, регистрации, конверсия
- **Logs:** централизованный сбор (ELK, Loki, Datadog)
- **Traces:** distributed tracing для микросервисов (Jaeger, Zipkin)
Alerting
- P0 (система недоступна) — immediate call
- P1 (деградация) — Slack notification, 15 минут на реакцию
- P2 (аномалия) — email digest, проверить в течение часа
Rollback: план Б всегда готов
Даже при идеальном CI/CD бывают проблемы. Вопрос не "будет ли сбой", а "как быстро вы восстановитесь".
Стратегии деплоя
- **Blue-green deployment** — две идентичные среды, мгновенное переключение
- **Canary release** — 5% трафика на новую версию, постепенное увеличение
- **Feature flags** — отключение функционала без отката кода
Rollback checklist
- Версия кода тегирована
- Database migrations обратимы
- Конфигурация версионирована
- Команда знает процедуру отката
- После инцидента — postmortem без blame culture
Выводы
DevOps — это культура, а не набор инструментов. Это уверенность, что каждое изменение можно безопасно доставить до пользователей. Это прозрачность, которая позволяет реагировать на проблемы за минуты, а не часы.
Начните с простого: автоматизируйте тесты, настройте CI/CD, добавьте мониторинг. Каждый следующий шаг будет проще предыдущего.
Похожие статьи
 loading="lazy" decoding="async"
 loading="lazy" decoding="async"
Хотите внедрить это в своём проекте?
Опишите задачу — мы предложим подход, сроки и стоимость реализации.
Обсудить проект